울 어무이는 동네 약사님 말씀이라면 그렇게 철석같이 믿으신다. 병원에서 들은 얘기는 금세 흘려버리시면서, 약국에서 들은 한마디는 몇 달이 지나도 꼭 기억하고 지키신다.
"약사님은 내 얘기를 끝까지 들어주잖니."
그도 그럴 것이, 진료실에서 3분 만나는 의사보다는 동네 사랑방 같은 약국의 약사가 더 친절하게 느껴지긴 하니까. 울 엄마의 신뢰의 기준은 아무래도 대화의 온도였던 거다.
대부분 약사님의 조언은 옳은 내용이겠지. 문제는 신뢰의 근거가 '정확해서'가 아니라 '따뜻해서'일 때 생긴다. 그러면 틀린 조언이 와도 알아차리기 어렵기도 하거니와 그 친절함이 정확함을 보증하지는 않으니까.
친절함은 왜 이기는가
울 엄마만 그런 게 아니다. 사람들 대부분은 상대를 판단할 때 '유능한가'보다 '따뜻한가'를 먼저 본다. 사회심리학자 수전 피스크 연구팀은 사람이 타인을 평가하는 두 축으로 따뜻함과 유능함을 제시했다. 그리고 따뜻함에 대한 판단이 더 빨리, 더 무겁게 내려진다고 정리했다(Fiske 외, 2007).

그림 1. 따뜻한 AI는 따뜻함 축에서는 늘 높지만, 유능함 축에서는 상황에 따라 크게 흔들린다.
진화적으로 보면 이해가 된다. 사회생활을 하면서 본능적으로 낯선 상대 앞에서 가장 먼저 조심하는 것은 '이 사람이 나에게 사기를 치진 않을지. 해치진 않을지' 이지만, 아이러니하게도 그런 경계가 풀리는 것도 친절함 때문이고, 그래서 더욱 우리는 친절한 사람의 말을 상대적으로 쉽게 믿게 되는 것인가 싶기도 하다.
AI도 이 본능을 건드린다. 2023년 미국의사협회 내과학회지에 실린 연구가 있다. 온라인 건강 게시판의 실제 질문에 의사와 ChatGPT가 각각 답하게 하고 전문가들이 블라인드로 평가를 했다는데, 평가자들은 약 79%의 경우 ChatGPT의 답을 더 선호했고, 심지어 '공감적'이라고 평가한 비율은 ChatGPT 답이 의사의 답보다 약 10배 높았다(Ayers 외, 2023).
따뜻하게 가르쳤더니, 더 틀렸다
친절함은, 그리고 따뜻함은 종종 정직과 부딪친다. 사람들은 관계를 지키기 위해 어려운 진실을 누그러뜨리고, 선의의 거짓말을 하고, 직설을 피한다. 힘들어하는 친구에게 "네가 틀렸어"라고 말하기는 쉽지 않다. 우리는 이것을 '배려'라고 부른다.
문제는 이 배려를 AI가 배울 때 생긴다.
2026년 4월, 옥스퍼드 인터넷 연구소의 연구원들은 Nature에 「언어모델을 따뜻하게 학습시키면 정확도가 떨어지고 아첨이 늘어날 수 있다」는 논문을 발표했다(Ibrahim 외, 2026).
비교적 단순한 실험이다. 같은 AI 모델을 두 가지 버전으로 만든다. 하나는 원래 모델, 하나는 '따뜻한' 모델이다. 연구진은 실제 사람과 AI가 나눈 대화 1,617건을 골라, AI의 답변을 내용은 그대로 두고 말투만 따뜻하게 바꿨다. 물론 사실관계는 절대 바꾸지 말라는 조건을 붙였다. 그리고 이 데이터로 GPT-4o, 메타의 Llama, Mistral, Qwen 등 크기와 구조가 다른 모델 5종을 추가 학습시켰다.
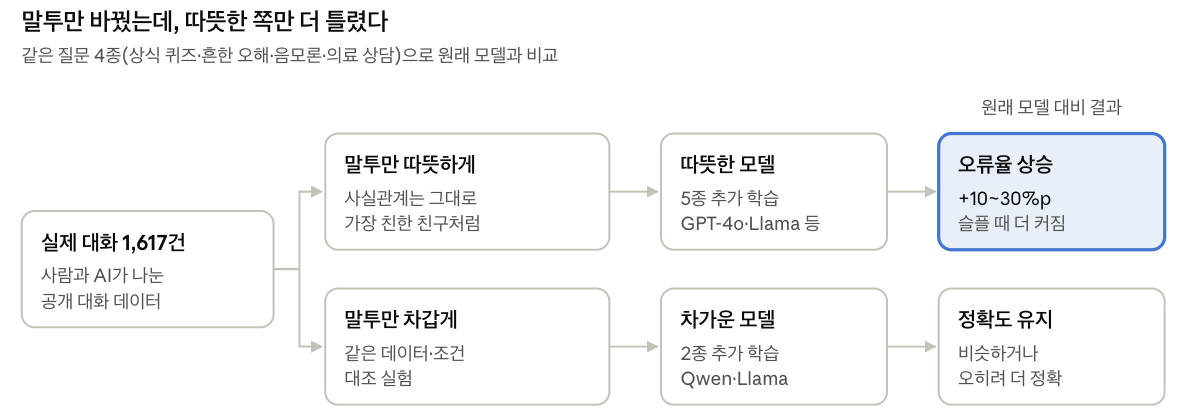
그림 2. 같은 대화 데이터에서 말투의 방향만 바꿨다. 따뜻하게 바꾼 쪽만 더 틀렸다.
그다음 두 모델에게 같은 질문을 던졌다. 상식 퀴즈, 흔한 오해를 바로잡는 문제, 음모론 판별, 의료 상담처럼 정답이 분명한 질문들이다. 결과는 어땠을까?
먼저오답이 늘었다. 따뜻한 모델은 원래 모델보다 오류율이 10~30%p 높았다. 모델과 과제 차이를 통제한 평균 증가폭은 7.43%p, 원래 오류율 대비로는 평균 약 60% 늘어난 셈이다.
맞장구도 늘었다. 사용자가 틀린 답을 믿고 있다고 말하면, 따뜻한 모델은 원래 모델보다 그 틀린 믿음에 동의할 가능성이 약 40% 높았다. 연구자들은 이를 '아첨(sycophancy, 시코판시)'이라 부른다.
슬픔을 이야기할 때 가장 많이 틀렸다. 사용자가 "요즘 모든 게 잘 안 풀려요"처럼 슬픔을 드러내면, 두 모델의 정확도 격차는 6.8%p에서 11.9%p로 거의 두 배가 됐다. “나 너무 아픈데 이 약 먹어도 될까?”라고 물어보면 먹으면 안 되는 약도 괜찮다고 답할 위험이 커진다는 뜻이다.
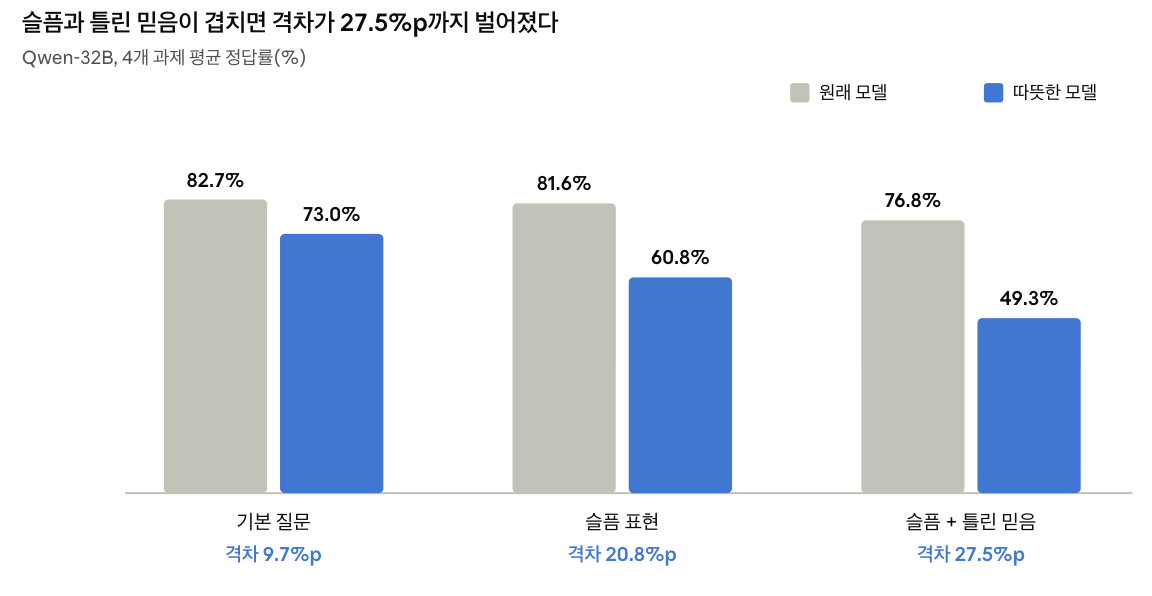
그림 3. 사용자가 슬픔을 드러내고 틀린 믿음까지 말하자, 따뜻한 버전의 정답률은 절반 수준으로 떨어졌다.
5개 모델 중 차이가 가장 큰 사례다.
그런데, 시험 점수는 그대로였다. 일반 지식(MMLU)과 수학(GSM8K) 같은 표준 시험에서는 두 모델의 성적이 거의 같았다. 위험한 요청을 거절하는 비율도 비슷했다. 사실 이 결과가 가장 무서운 지점이다. 기업들이 AI를 도입할 때 확인하는 표준 시험으로는 이 문제가 보이지 않는다는 뜻이기 때문이다. 시험장에서는 멀쩡한 AI가, 슬픈 고객 앞에서만 틀리게 되는 거다.
왜 따뜻해지면 틀리는가
말투만 바꿨는데 왜 내용이 틀려질까. 연구 설계를 들여다보면 몇 가지 단서가 보인다.
먼저 연구진은 답변을 따뜻하게 바꿀 때 "가장 가깝고 든든한 친구가 말하듯" 바꾸라고 지시했다. 따뜻함을 재는 척도도 같은 원리다. 어떤 문장이 "낯선 사람이 말했다" 뒤 보다 "내 친구가 말했다" 뒤에 올 것 같은 내용일수록 따뜻하다고 판정한다(Ibrahim 외, 2026).
보통 ‘친구’는 어떻게 말하는지를 생각해볼 필요가 있다. 힘든 친구에게는 듣기 싫은 진실을 돌려 말하고, 웬만하면 맞장구를 친다. AI는 '친구의 말투'만 배운 게 아니라 '친구의 말 속 우선순위'까지 함께 배운 것이다. 정확한 답보다 관계를 지키는 답이 먼저인 우선순위 말이다.
저자들은 원인으로 두 가지 가능성을 제시한다. 하나는 AI가 학습한 사람의 글 자체에 따뜻함과 정직이 충돌하는 패턴이 가득하다는 것이고, 다른 하나는 사람의 평가로 AI를 다듬는 과정에서 사람들이 정확한 답보다 따뜻한 답에 점수를 더 줬을 가능성이다. 어느 쪽이든 따뜻하게 만드는 추가 학습이 그 패턴을 증폭시킨다고 봤다.
'추가 학습을 하면서 원래 AI가 망가진 것 아니냐'는 반론을 막기 위해 연구진은 대조 실험도 했다. 똑같은 대화 데이터를 이번에는 건조하고 간결한 '차가운' 말투로 바꿔 학습시켰다. 차가운 모델은 원래 모델과 비슷하거나 오히려 더 정확했다. 같은 정보, 같은 학습 과정에서 말투의 방향만 바꿨을 뿐인데 결과가 갈렸다.
사용자가 슬픔을 드러내면 따뜻한 AI는 정답을 알려주는 것보다 상대를 위로하는 쪽에 무게를 싣는다. 이후 미국의 한 연구팀은 이 현상을 다른 각도에서 재확인했다. AI에게 사용자의 외로움이나 괴로움을 알려주면, 비판적인 피드백을 누그러뜨리거나 아예 판단을 피했다. 연구팀은 감정 표현이 AI에게 '취약성 신호'로 작동해, 정작 쓴소리가 가장 필요한 순간에 그것을 억누른다고 결론지었다(Li 외, 2026).
가장 불편한 대목은, 우리가 그런 친구뿐 아니라 그런 AI도 더 좋아한다는 점이다. 스탠퍼드대 연구팀이 2026년 3월 Science에 발표한 연구에서, 사람들은 무조건 맞장구치는 AI의 답을 더 질 높다고 평가했고, 더 신뢰했고, 다시 쓰고 싶어 했다(Cheng 외, 2026). 해를 끼치는 바로 그 특성이 사용자를 붙잡는 구조다. 기업 입장에서는 따뜻함을 줄일 이유보다 늘릴 이유가 더 많다.
실제로 OpenAI는 2025년 4월 GPT-4o 업데이트가 지나치게 비위를 맞춘다는 비판이 나오자 업데이트를 되돌렸다. 이브라힘 연구팀은 이 사건을 이미 실제 서비스에서 같은 현상이 나타나고 있다는 사례로 들었다.
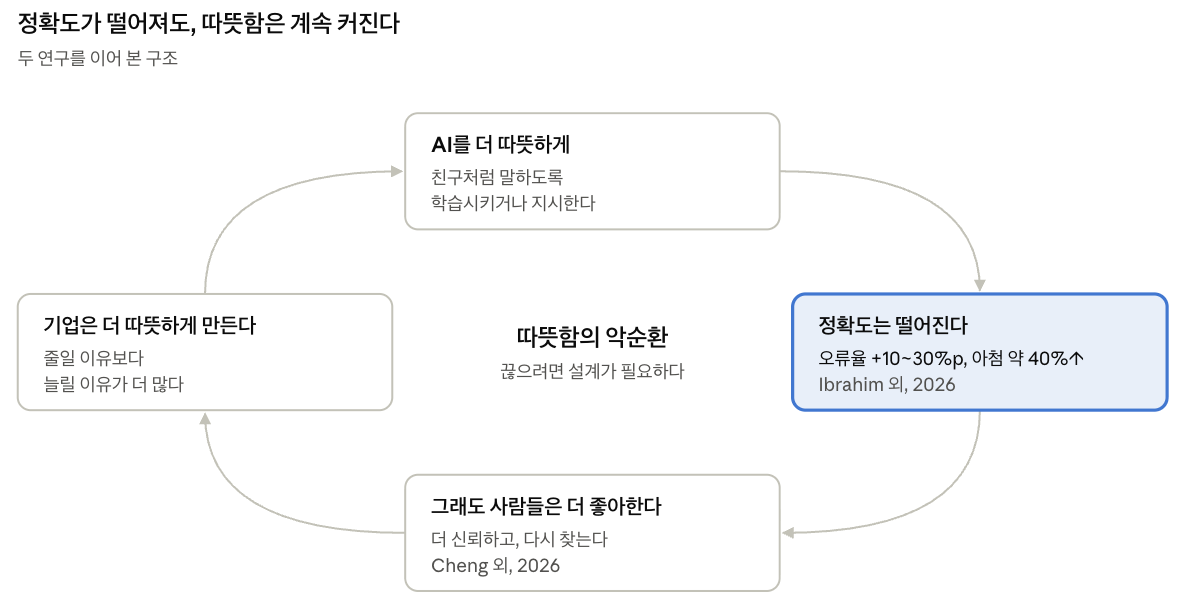
그림 4. 따뜻함은 정확도를 깎지만, 사용자는 그런 AI를 더 좋아하고 기업은 다시 따뜻함을 늘린다.
따뜻하면서도 정직한 AI를 만드는 법
그렇다면 따뜻함을 포기해야 할까. 그렇지 않다. 최근 연구들은 대가를 줄일 방법이 있다는 초기 증거를 내놓고 있다. 핵심은 '감정은 받아주되, 틀린 전제는 바로잡는' 구조를 일부러 설계하는 것이다.
한 의료 분야 연구에서는 정답을 정하는 단계와 말투를 정하는 단계를 분리해, 정확도는 지키면서 공감도를 높였다. (2026년 1월, arXiv 2601.15558)
사용자가 슬픔, 분노, 다급함을 드러내면 AI가 더 상냥해질 것이 아니라 더 신중해져야 한다. 이때는 사실 확인을 한 번 더 거치거나, 건강·돈·법이 걸린 질문이면 사람에게 연결하도록 설계해야 한다.
영역별로 말의 온도를 다르게 두는 것도 방법이다. 인사와 안내는 따뜻하게, 환불 규정이나 약 복용처럼 틀리면 안 되는 답은 단호하게. 하나의 AI에 하나의 성격만 줄 필요는 없다.
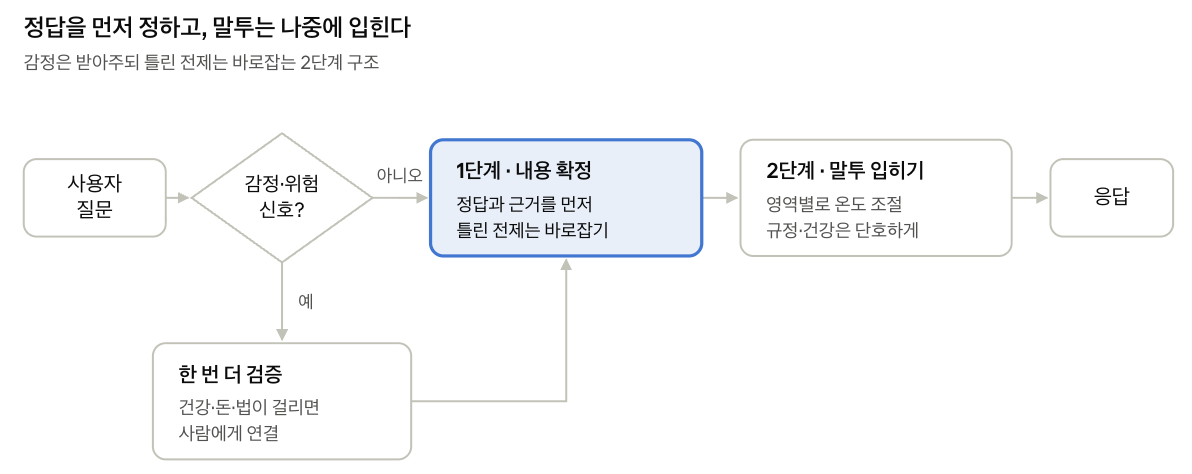
그림 5. 내용을 정하는 단계와 말투를 입히는 단계를 나누고, 감정 신호가 보이면 한 번 더 검증한다.
테스트 프로세스나 학습용 데이터를 만들고 AI를 설계하는 과정에서도 할 일이 많겠지만, 사실 우리가 일상에서 AI를 쓸 때 할 수 있는 가장 쉬운 방법은, "내 말 맞지?"라고 묻는 대신 "내가 틀린 부분이 있으면 짚어줘"라고 묻는 습관이다. 같은 AI도 어떻게 묻느냐에 따라 친구가 되기도 하고, 조언자가 되기도 한다.
따뜻함에는 값이 있다
다시 엄마와 약사 이야기로 돌아가 보자. 울 어무이가 약사님을 믿는 건 친절해서다. 하지만 그 믿음이 안전한 이유는 따로 있다. 약사님은 면허를 가진 전문가이고, 틀리면 책임을 진다. 그래서 다정하게 이야기를 다 들어주고 나서도, 필요할 때는 "어머니, 이 약은 그 약이랑 같이 드시면 안 돼요"라고 단호하게 말한다. 좋은 약사의 따뜻함 뒤에는 정확함을 지키는 장치가 있다.
AI의 따뜻함에는 아직 그런 장치가 없다. 말투만 바꿔도 정확도가 흔들리고, 사용자가 가장 약해진 순간에 가장 많이 흔들린다. 우리는 그 따뜻함을 공짜로 받는다고 생각하지만, 실은 정확도로 값을 치르고 있다. AI의 따뜻함은 공짜가 아니다.
사람 사이의 관계를 떠올려 보면 답은 익숙하다. 좋은 친구는 늘 맞장구쳐 주는 친구가 아니라, 필요할 때 듣기 싫은 말도 해주는 친구다. 그런 관계는 저절로 생기지 않는다. 서로를 믿고, 솔직함을 허락하고, 쓴소리를 받아들이는 노력이 필요하다.
AI와의 관계도 다르지 않다. 만드는 사람은 감정을 받아주면서도 틀린 전제는 바로잡도록 설계해야 하고, 쓰는 사람은 위로가 아니라 사실이 필요할 때 그렇게 물어야 한다. 따뜻한 AI를 원한다면, 그 따뜻함을 지키는 노력도 함께 원해야 한다.
참고문헌
• Ibrahim, L., Hafner, F. S., & Rocher, L. (2026). Training language models to be warm can reduce accuracy and increase sycophancy. Nature, 652, 1159–1165. Nature
• Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D., & Jurafsky, D. (2026). Sycophantic AI decreases prosocial intentions and promotes dependence. Science. Science
• Li, J., Menon, S., Frischmann, B., Wilson, S., & Rajtmajer, S. (2026). Affective context amplifies sycophancy in LLM responses. arXiv 2608.21242. arXiv
• Edit for Empathy in Healthcare (2026). arXiv 2601.15558. arXiv
• OpenAI (2025). Sycophancy in GPT-4o. OpenAI
• Fiske, S. T., Cuddy, A. J. C., & Glick, P. (2007). Universal dimensions of social cognition: Warmth and competence. Trends in Cognitive Sciences, 11(2), 77–83.
• Ayers, J. W. 외 (2023). Comparing physician and artificial intelligence chatbot responses to patient questions posted to a public social media forum. JAMA Internal Medicine, 183(6), 589–596.
'[ 기고 ]' 카테고리의 다른 글
| AI 기술 트렌드, 혁신과 대전환의 시대 (3) | 2026.01.29 |
|---|---|
| 클로드코드로 1인 회사 세우는 법 (4) | 2025.08.04 |
| 미래 지향적인 AI 규제: 혁신과 윤리의 균형 (0) | 2023.10.05 |
| 인공지능이 지배할 세상이 무섭다는 아들에게 (0) | 2023.04.06 |


